
凌晨三点的崩溃现场
2025年深秋,凌晨3点17分,某聚变模拟课题组的服务器机房里,一台已经连续跑了四天三夜的机器安静了下来。屏幕上最后一行日志写得轻描淡写:内存分配失败,进程终止。被终止的是一个回旋动理学算例——五维相空间网格刚按计划加密了一倍,自由度从十亿量级跳向百亿量级,内存占用曲线在监控图上拉出一道接近垂直的悬崖。第二天早上是组内阶段汇报,算例重来意味着至少再耗一周,而离课题的年度节点只剩下一个月。
复盘会上没有人质疑算法。大家盯着投影上的参数列表沉默了很久,最后得出一个朴素到有点扎心的结论:程序没写错,物理模型没设错,是机器扛不住了。这台机器当年采购时按”能跑通教学算例”的标准配的,谁也想不到课题组的方向会从”理解物理”一路推到”预测装置”。
磁约束聚变数值模拟这个领域的残酷之处在于,它的算力需求从来不是线性增长的——你以为只是网格加密一档,机器面对的可能是三十二倍的内存账单。
追因:这台机器是怎么被一步步耗死的
要理解崩溃的来龙去脉,得先看这个方向的模拟任务分几层。每一层对硬件的索取方式完全不同,踩错任何一层的判断,都会以凌晨三点的方式回报给你。
第一层:MHD平衡重建与输运模拟
托卡马克等离子体的整体行为,宏观上可以用磁流体动力学(MHD)描述。平衡重建的任务,是从装置的磁诊断信号反推出磁面结构;输运模拟则沿着磁面把粒子、能量、动量的输运过程沿径向一维展开,核心是求解一大串耦合的抛物型方程组。这类计算是典型的CPU密集型负载:单核性能决定单步耗时,核数决定能并行铺开多少条通量管。2025年1月,合肥的EAST装置实现1亿摄氏度1066秒稳态高约束模运行,创下世界纪录;同年5月,中国环流三号又宣布实现百万安培亿度高约束模运行。装置参数每推进一步,反向抛给输运模拟的算题尺度就涨一截,但这一层对硬件还相对客气——一台像样的多核工作站就能从容应对。
第二层:回旋动理学的相空间维度灾难
真正的杀手藏在第二层。要研究等离子体微观不稳定性——那些会让上亿度的”火球”突然撕裂磁面、导致大破裂的罪魁祸首——必须把离子的回旋半径尺度也纳入计算,这就是回旋动理学。它的自由度分布在五维相空间:三维实空间加上两个速度空间维度,每个维度再切几十上百个网格点。内存需求随分辨率按幂次膨胀,五个维度各加密一倍,总自由度直接翻到三十二倍。GENE、CGYRO这类程序的算例,规模稍一认真,内存就奔着数百GB去,而且它们对内存带宽极度敏感——几十个核抢内存通道的场面,和早高峰地铁没什么区别。
第三层:边界等离子体与集成建模
再往外推到装置边界,偏滤器热负荷、刮削层湍流要靠BOUT++这类边界模拟程序处理;而要把平衡、输运、加热、电流驱动串成一条链预测装置表现,还得依赖OMFIT、TRANSP这类集成建模框架。这两层叠加,意味着机器既要大内存扛矩阵,又要够多的核跑耦合,还得有像样的单卡或多卡GPU给加速器代码留后路。
当时我们用的那台机器
出事的是一台二十四核、64GB内存、单张24GB显存的通用工作站。客观说,它当年完全胜任:课程级平衡重建、学位论文入门算例、实验数据的日常整理,都在它上面跑得稳稳当当。问题出在课题方向的跃迁——组里接下了面向下一代装置尺度的动理学研究,而采购清单停留在上一个时代。网格加密计划书里白纸黑字写着内存预估,只是没人当真,直到凌晨3点17分。
大模型离线部署:让工作站兼任聚变实验的”数据文书”
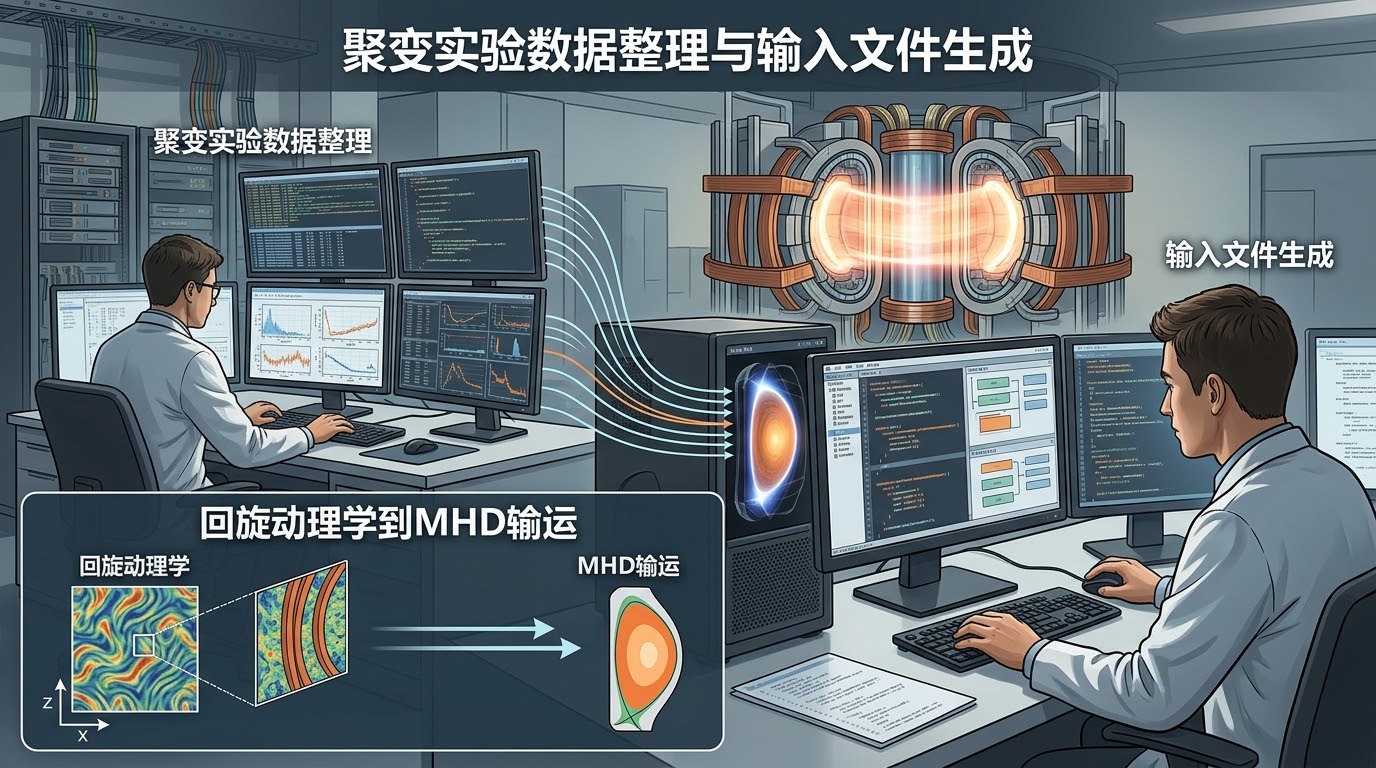
聚变模拟还有一个隐性负担鲜少有人算进硬件规划:算例之外的海量”文书工作”。一次放电实验产生成堆的诊断数据,清洗、归档、对齐时间戳要花掉研究生大量时间;反过来,GENE的输入参数卡、平衡文件的前处理、算例说明文档的撰写,全是高度模板化却不得不做的杂活。用大模型接管这些杂活,正是近两年聚变领域AI化的真实趋势——2026年1月,中国科学技术大学、中科院等离子体所与科大讯飞研究院组成的联合团队就发布了面向EAST的等离子体响应预测模型PaMMA-Net,用深度神经网络给”人造太阳”装上了预判系统。
这类活儿为什么必须大模型离线部署,而不是随手调个云端API?原因有三:一是装置诊断数据带有实验保密属性,根本不允许出内网;二是实验和模拟数据要长期留存复用,云端订阅制的长期成本远高于一次性本地部署;三是机房和实验室的网络环境常常隔离,离线可用是硬指标。
模型选型上,两个开源代表恰好覆盖两档需求。整理诊断数据、生成模拟输入文件这类结构化任务,Qwen3-30B-A3B是当下最划算的选择——稀疏MoE架构,总参数30.5B、每token只激活3.3B,却能在代码和数学推理上逼近70B级稠密模型。需要更强的报告综合与长文档推理能力时,则轮到Llama-3.3-70B出场。
显存怎么估?按行业通行的口径:所需显存约等于参数量乘以量化字节数再乘以1.2的KV cache与系统开销系数(FP16为2字节,Q8为1字节,Q4为0.5字节)。两个算例:Qwen3-30B-A3B在Q4下约需30.5×0.5×1.2≈18GB,24GB显存即可从容运行,且因为激活参数小,解码速度相当可观;Llama-3.3-70B在Q4下约需70×0.5×1.2≈42GB,单张48GB以上显存的卡才装得下,双卡则更为宽松。这里有个针对MoE的常见误会必须澄清:Qwen3-30B-A3B虽然每步只激活3.3B参数,但全部30.5B参数的权重都得常驻显存,MoE省的是算力,省不了显存。量化等级的选择也讲究:FP16精度无损但显存翻倍,Q8几乎无损且体积减半,Q4损失约12个百分点的基准表现却是消费级部署的默认档——对输入文件生成这类任务,这点精度损失无关紧要。速度量级上,纯CPU推理只有个位数tokens/s,生成一份参数卡要等上几分钟;单卡GPU则轻松跑到几十甚至上百tokens/s,交互体验完全是两回事。最后还要留一眼微调:用LoRA对30B级模型做聚变语料适配,显存增量只需35GB;但若想全参数微调7B模型,80GB显存起步——这决定了你的配置档位能探到哪里。
工具体系:聚变模拟软件地图
聊完硬件需求,顺手把软件版图也铺开,方便对号评估自己处在哪一层。
平衡与输运层
- EFIT:托卡马克平衡重建的事实标准,从磁诊断反演磁面位形,CPU单线程友好,适合高频次快速反演
- CHEASE:固定边界平衡求解器,常为稳定性分析提供平衡输入
- TRANSP:把输运、加热、电流驱动整合进时间演化链条的集成模拟主力
- OMFIT:把各类代码串成工作流的集成框架,本世纪初由普林斯顿等团队发展起来,如今已是各装置模拟的”总装车间”
动理学与稳定性层
- GENE、GYRO、CGYRO:回旋动理学模拟的三驾马车,五维相空间求解,主攻微湍流输运,规模一上来就是内存带宽的极限测试
- MISHKA等理想MHD稳定性代码:特征值问题求解,搭配PETSc、SLEPc这类数值库食用
边界与数据层
- BOUT++:边界等离子体湍流的开源框架,偏滤器热负荷研究的常客
- MDSplus与HDF5:实验与模拟数据的事实标准载体,数据的读写IO性能会实打实影响日常效率
配置推荐:按”抗崩等级”给机器分级
原理聊得再多,最终还是要落到”这台机器能不能在凌晨三点不罢工”这个朴素问题上。聚变模拟的任务弹性极大,从教学级平衡重建到全装置尺度的五维动理学,硬件胃口差着几个数量级。下面这几档配置,是按前面分析的崩溃机理,以”抗崩等级”为纲整理的参考——你可以把它理解为一份保险条款,保额对应你能睡的安稳程度。
方案A:抗”课程级与诊断反演”崩
适用场景:MHD平衡重建、一维输运模拟、实验诊断数据整理、Qwen3-30B-A3B级大模型离线部署(Q4量化约18GB显存,本档即可落地)
推荐机型:A350 153128-MCT
- CPU:Intel Ultra9 285K(24核,8P核5.6GHz)+水冷
- GPU:RTX 5090D v2 24GB+水冷
- 内存:128GB DDR5
- 存储:4TB NVME + 8TB SATA
- 显存:24GB
- 显存带宽:1.34 TB/s
- 注:CPU频率为UltraLAB全核超频实测优化频率。
方案B:抗”中等尺度回旋动理学”崩
适用场景:五维动理学中等规模算例(单个方向网格加密不再触发内存不足)、OMFIT多工作流串联、Llama-3.3-70B本地部署(Q4量化单卡可容,长文档报告生成从容)
推荐机型:GA650M 230512-MC2D
- CPU:2×AMD霄龙75F3(64核,3.8GHz+)
- GPU:2×RTX Pro 5000 72GB
- 内存:512GB DDR5
- 系统盘:4TB NVME
- 数据盘:20TB SATA
- 显存:144GB
- 显存带宽:2×1.34 TB/s
- 注:CPU频率为UltraLAB全核超频实测优化频率。
方案C:抗”全装置尺度五维动理学”崩
适用场景:接近真实装置参数的动理学参数扫描、BOUT++边界湍流GPU加速、多算例并发排队、双70B级模型并发服务全组
推荐机型:GX660M 235640-MD4A
- CPU:2×AMD霄龙75F3(64核,3GHz+)
- 图形卡:RTX A1000
- 计算卡:4×A100 80GB+水冷
- 内存:640GB DDR5
- 系统盘:4TB NVME
- 数据盘:20TB SATA
- 显存:8GB / 320GB
- 显存带宽:192 GB/s / 4×2 TB/s
- 注:CPU频率为UltraLAB全核超频实测优化频率。
方案D:抗”多团队并发与参数洪流”崩
适用场景:燃烧等离子体级别的集成建模、成百上千个动理学算例的参数扫描、多课题组共享的私有化算力平台
推荐机型:分布式集群 8.6 科学计算通用型
- 计算节点CPU(二选一):2颗AMD霄龙9575F(128核,4.5GHz) / Ultra9 285K(8P核,5.6GHz)
- 计算节点GPU(二选一):RTX 4090D / RTX A4000
- 内存(二选一):768GB DDR5 / 64GB DDR5
- 存储(二选一):2TB NVME / 2TB NVME
- 显存(二选一):24GB / 16GB
- 显存带宽(二选一):1.01 TB/s / 448 GB/s
- 存储管理节点:2颗Xeon银牌4310(24核),192GB DDR4内存,126TB并行存储
- 注:CPU频率为UltraLAB全核超频实测优化频率。
常见问题
如果重来,当时应该直接上顶配吗?
未必。回顾那次崩溃,真正的失误在于”用上一阶段的任务画像买下一阶段的机器”。入门阶段买顶配,一半的预算会闲置三年以上;正确姿势是买对档位、留好升级路径,把内存插槽、盘位和电源余量当成续命条款来谈判。
回旋动理学模拟,CPU和GPU哪个更重要?
分阶段看。前处理与大规模本征值求解吃CPU主频与内存容量;GENE、CGYRO的主求解循环和BOUT++都已支持GPU加速,但显存容量往往先触顶——五维分布函数一张双精度快照就可能吃掉十几GB。两头都要硬,这正是这类负载”挑剔”的原因。
64GB内存到底够不够跑动理学?
取决于你敢不敢加密网格。粗略感受:五维网格每维取适中的几十个点,双精度下轻松突破64GB;上到装置尺度,256GB只能算起步。选购时把目标算例的自由度数出来、乘以16字节估算,比任何口碑都可靠。
大模型离线部署会影响模拟计算抢资源吗?
会,所以要在软件层面做隔离:推理服务限定显存配额、模拟任务用调度器排队,或者干脆把LLM服务绑在GPU、把CPU密集型的MHD求解绑在CPU上,让两类负载物理错峰。Qwen3-30B-A3B这类MoE模型激活参数小,与模拟任务错峰共享GPU比稠密70B容易得多。
自攒一台大内存机器能省钱吗?
账面能省,隐性成本未必。五维动理学对内存通道数和带宽的压榨极其苛刻,主板走线、内存品牌混插、BIOS设置任何一处掉链子,表现出来都是”程序没错但跑不完”。商用整机的价值在于这些坑出厂前已经替你踩过一遍。
数据存储需要专门规划吗?
需要,而且容易被低估。一次中等规模的动理学扫描就能产出数TB的分布函数快照,MDSplus树和HDF5归档对随机读写都有要求。系统盘与数据盘分离、预留足够的NVMe容量给热数据,是避免”算得动、存不下”的基本功。
结语
那天凌晨的崩溃报告最后一行写着:事故根因,算力储备与课题增长曲线失配。聚变模拟的算力需求曲线是幂律增长的,而采购预算往往是线性批复的,这个错配几乎注定反复上演。能做的,是把机器的”抗崩等级”写进任务规划书里,让每一次网格加密都对应一份睡得着觉的硬件冗余。算力储备从某种意义上说是一种保险——灾难发生的那个凌晨,保额决定你能不能按期毕业、按时结题。
工作站配置选型欢迎咨询~
微信号:maxftxwx
fuyiqin@xasun.com












