
UltraLAB HPC Cluster
面向 AI / HPC / EDA 的异构 GPU 集群交付验证报告 —— 覆盖软件栈与模块核查、Slurm GPU+CPU 混合作业实测、Open OnDemand Web 提交、全栈监控,以及专业模式下的销售优势分析。
集群规模:3 节点(1 控制 + 2 GPU 计算)GPU:3× NVIDIA(GTX 750 / 1050 ×2)调度:Slurm 26.05.3门户:Open OnDemand 4.2CUDA 12.8.2 · 驱动 580.178.04报告日期:2026-10-09
摘要Abstract
Abstract — Verification & value assessment of the UltraLAB heterogeneous GPU cluster.
UltraLAB HPC Cluster 是一套以 Ansible 声明式交付的异构 GPU 集群:由 1 个控制/门户/监控节点(Intel Xeon Gold 5218 / 30 GB / GTX 1050)与 2 个 GPU 计算节点(i7-6700T / GTX 750、i5-9600K / GTX 1050)组成,统一由 Slurm 26.05.3 调度,通过 Open OnDemand 4.2 Web 门户提交交互式与批处理作业,并以 Prometheus 3.13.0 + DCGM + Grafana 13.1.0 实现全栈可观测。
本报告基于真实运行环境逐项实测完成:(1) 核查了 6 个 Lmod 软件模块、33 个门户应用与 49 个监控插件;(2) 实测 Slurm GPU+CPU 混合作业,验证 TRES 资源(cpu=4 + gres/gpu=1)同时分配、CPU 亲和性、GPU 可见性与 CUDA 内核执行全链路成功;(3) 梳理了”驱动 → CUDA/HPC SDK → Enroot/Pyxis → Slurm → OOD → 监控”的模块交互链路;(4) 重点介绍了 OOD-Web 的图形化提交能力;(5) 给出专业模式下的销售优势评分与结论。
关键词:异构 GPU 集群 · Slurm 调度 · TRES 混合资源 · Open OnDemand · CUDA 12.8 · Enroot/Pyxis 容器 · Prometheus/DCGM/Grafana 可观测 · 声明式 Ansible 交付
目录Contents
- 01集群概述与节点规格
- 02软件栈与模块核查
- 03模块交互与工作流
- 04Slurm GPU+CPU 混合提交(实测)
- 05OOD-Web 提交介绍(重点)
- 06全栈监控体系
- 07使用说明书
- 08销售优势报告
- 09结论与交付物
- A附录:实测证据日志
01集群概述与节点规格
Cluster topology & node specification — 3-node heterogeneous GPU cluster
集群采用”控制/门户/监控合一 + 专用 GPU 计算”的经典 HPC 拓扑。所有节点运行 Rocky Linux 9,共享 NFS 家目录(/home)与软件栈(/sw),由 Slurm 统一调度,GPU 通过 gres/gpu TRES 暴露给作业。
| 节点 | 角色 | CPU | 核心/线程 | 内存 | GPU | 显存 | 状态 |
|---|---|---|---|---|---|---|---|
| master (192.168.0.200) | 控制 / 门户 / 监控 | Intel Xeon Gold 5218 @2.30GHz | 16C / 32T | 30 GB | GTX 1050 | 2 GB | 在线 |
| gpu01 (192.168.0.201) | GPU 计算 | Intel Core i7-6700T @2.80GHz | 4C / 8T | 7.2 GB | GTX 750 | 1 GB | IDLE |
| gpu02 (192.168.0.202) | GPU 计算 | Intel Core i5-9600K @3.70GHz | 6C / 6T | 14.9 GB | GTX 1050 | 2 GB | IDLE |
3
集群节点
1 控制门户 + 2 GPU 计算节点,全 Rocky Linux 9
3
GPU 加速器
GTX 750 (Maxwell sm_5.0)、GTX 1050 (Pascal) ×2
1
调度分区
batch 分区,MaxTime=INFINITE,无抢占,作业时长不限
∞
TRES 混合
cpu / mem / billing / gres/gpu 多维资源统一核算分配
调度事实(scontrol/sinfo 实测) 分区 batch:2 个计算节点均可用;CfgTRES = cpu, mem, billing, gres/gpu:1;抢占模式 OFF,作业时长 1–infinite。GPU 在普通 SSH 会话中被隐藏,仅在 Slurm 作业内可见——这是刻意的安全隔离设计。
02软件栈与模块核查
Software stack & module inventory — 全组件版本逐项核查
2.1 核心软件栈版本
| 组件 | 版本 | 职责 | 核查状态 |
|---|---|---|---|
| Slurm | 26.05.3 | 作业调度 / 资源管理(TRES、GRES) | ✓ 运行 |
| CUDA Toolkit | 12.8.2 | GPU 计算运行时(HPC SDK 23.7 内) | ✓ 内核执行成功 |
| NVIDIA HPC SDK | 23.7(nvhpc) | 编译器 / MPI / 数学库(nvcc、HPC-X) | ✓ 6 模块 |
| NVIDIA 驱动 | 580.178.04 | GPU 内核驱动(open kernel modules) | ✓ 3 节点 |
| Enroot | 3.2.0 | 轻量 GPU 容器运行时 | ✓ 就绪 |
| Pyxis | v0.11.1 | Slurm ↔ Enroot GPU 集成层 | ✓ 就绪 |
| Lmod | — | 环境变量模块管理(/sw 软件栈) | ✓ 可用 |
| Apache HTTPD | 2.4.62 | OOD 门户前端(Rocky Linux) | ✓ 运行 |
| Open OnDemand | 4.2 | Web 门户 / Batch Connect | ✓ 33 应用 |
| Prometheus | 3.13.0 | 指标采集 / 存储 / 告警 | ✓ 8 目标 up |
| Grafana | 13.1.0 | 可视化 / 仪表盘(database ok) | ✓ 2 仪表盘 |
| 操作系统 | Rocky Linux 9 | 全节点基础系统 | ✓ 统一 |
2.2 Lmod 软件模块(NVIDIA HPC SDK 23.7)
软件栈以 NVIDIA HPC SDK 23.7 为核心,提供 6 个 Lmod 模块变体,覆盖”带 MPI 全功能 / 无 MPI / 自带编译器 / HPC-X 高性能网络(CUDA 11 / 12)”等场景,用户可通过 module load nvhpc/23.7 一键获得 nvcc、编译器、MPI 与数学库:
nvhpc/23.7 · 全功能(含 MPI)nvhpc-nompi/23.7 · 无 MPInvhpc-byo-compiler/23.7nvhpc-hpcx/23.7 · HPC-Xnvhpc-hpcx-cuda11/23.7nvhpc-hpcx-cuda12/23.7
2.3 Open OnDemand 应用目录(33 个)
门户提供覆盖”交互式 GUI 工程软件 / 服务器端数据科学 / 桌面 / 教学 / 作业管理 / 文件 / 集群工具”的完整应用矩阵,并已全量中文化(导航分类、子分类、界面文案):
| 分类(导航) | 应用 | 数量 |
|---|---|---|
| 交互式应用 · 图形界面 | abaqus · ansys_workbench · ansysedt · ansysfluent · comsol · cst_studio · feko · lumerical · matlab · ollama · paraview · pymol · schrodinger · vmd | 14 |
| 交互式应用 · 服务器 | alphafold · codeserver · jupyter · jupyter_spark · mlflow · rstudio_server · tensorboard | 7 |
| 交互式应用 · 桌面 / 课堂 | bc_desktop · classroom_jupyter · classroom_rstudio | 3 |
| 作业 | activejobs · myjobs · projects | 3 |
| 文件 | files · file-editor | 2 |
| 集群 | module-browser · shell · system-status | 3 |
| 核心 | dashboard(门户首页) | 1 |
核查结论 6 个软件模块、33 个门户应用、49 个监控插件、2 个 Grafana 仪表盘全部在册且状态正常;门户 33 应用全量 HTTP 200,Grafana 核心页 200,API database: ok。
03软件模块间交互与工作流
Module interaction & end-to-end workflow — 从驱动到门户的可观测链路
各组件并非孤立,而是一条层层递进、彼此约束的交付链。下图为一次”用户在浏览器提交 GPU 作业”所贯穿的完整路径:
1
NVIDIA 驱动
GPU 内核驱动,open kernel modules,为上层提供 /dev/nvidia*
580.178.04
2
CUDA / HPC SDK
运行时 + 编译器 + 数学库,作业内 GPU 计算底座
12.8.2 / 23.7
3
Enroot + Pyxis
轻量 GPU 容器,Pyxis 桥接 Slurm 的 GRES 给容器内进程
3.2.0 / v0.11.1
4
Slurm 调度
按 TRES(cpu/mem/billing/gres) 分配节点与 GPU,隐藏空闲 GPU
26.05.3
5
Open OnDemand
Web 门户,把 sbatch / 交互式会话封装成浏览器表单
4.2
6
Prometheus+DCGM
抓取节点 / GPU / Slurm 指标,统一时序存储
3.13.0
7
Grafana
GPU 与 SLURM 仪表盘,实时可视化与告警
13.1.0
3.1 关键交互契约
- 驱动 ↔ CUDA:驱动 580.178.04 提供内核接口,CUDA 12.8.2 在其上运行;按 GPU 代际选择 open/proprietary 内核模块(本集群 Turing 及更新用 open)。
- CUDA ↔ 容器:Enroot 打包应用镜像,Pyxis 将 Slurm 分配的
gres/gpu透传为容器内CUDA_VISIBLE_DEVICES,实现”作业级 GPU 隔离”。 - Slurm ↔ OOD:OOD 的 Batch Connect 应用把”节点/分区/核数/GPU 数/时长”等表单字段翻译为
sbatch/srun参数;门户不直接接触 GPU,全部经由 Slurm 授权。 - Slurm/GPU ↔ 监控:Slurm exporter(:8080)、node exporter(:9100)、DCGM exporter(:9400)三类指标统一汇入 Prometheus,Grafana 按
$hostname聚合,避免硬编码节点名。
3.2 一次 GPU 作业的生命周期
- 用户在 OOD Web 门户填写作业参数(分区 / 核数 / GPU 数 / 时长 / 脚本)并提交;
- OOD 生成
sbatch请求,Slurm 按 TRES 在batch分区匹配节点并分配gres/gpu; - slurmd 启动作业,Pyxis/Enroot 准备 GPU 容器环境,
CUDA_VISIBLE_DEVICES指向分配到的卡; - 作业内
nvidia-smi可见 GPU、nvcc编译、CUDA 内核执行; - DCGM 实时采集该卡利用率 / 显存 / 温度 / 功耗,Prometheus 存储,Grafana 呈现;
- 作业结束(
ExitCode 0),资源回收,节点回到IDLE。
04Slurm GPU+CPU 混合作业提交(实测)
Measured GPU + CPU hybrid allocation — TRES 多维资源同时分配
核心能力验证:单个作业同时请求 CPU 核与 GPU 卡。测试作业请求 --cpus-per-task=4 --gpus=1,在 gpu01 上运行,实测证据如下:
实测证据 · scontrol show job 51
JobId=51  JobName=hybrid2  JobState=COMPLETED  ExitCode=0:0
NodeList=gpu01   NumNodes=1   NumCPUs=4   CPUs/Task=4
ReqTRES = cpu=4,mem=7249M,node=1,billing=4,gres/gpu=1
AllocTRES = cpu=4,mem=7249M,node=1,billing=4,gres/gpu=1   ← 请求 = 实际分配,混合资源全部满足
实测证据 · 作业内资源可见性
=== CPU 分配 ===
nproc(作业内可见核数): 4
taskset CPU 亲和性: 33          ← 已绑定到分配的 4 核
SLURM_JOB_CPUS_PER_NODE=4
=== GPU 分配 ===
CUDA_VISIBLE_DEVICES=0
0, NVIDIA GeForce GTX 750, 1024 MiB, 962 MiB   ← 作业内 GPU 可见
实测证据 · CUDA 运行时全链路
GPU: NVIDIA GeForce GTX 750   CC=5.0   SMs=4   显存=969MB
cudaMalloc: no error
kernel launch+sync: no error   ← nvcc 编译 + GPU 内核执行成功
CPU
4 核同时分配
nproc=4、taskset 亲和性、SLURM_JOB_CPUS_PER_NODE=4 三处一致
GPU
1 卡同时分配
CUDA_VISIBLE_DEVICES=0,GTX 750 在作业内可见
计算
CUDA 内核执行
cudaMalloc 与 kernel launch+sync 均 no error
结果
作业成功
ExitCode 0:0,资源回收,节点回 IDLE
结论 Slurm 的 TRES 机制实现了 CPU + GPU 混合资源的原子化分配——一次调度同时锁定 4 个 CPU 核与 1 张 GPU,且请求与分配完全一致、作业内两种资源均可见、CUDA 计算链路贯通。这是”异构计算”区别于”纯 CPU 集群”的核心卖点,已实测验证。
最小可复现命令 sbatch --partition=batch --cpus-per-task=4 --gpus=1 --time=00:02:00 my_job.sh 作业内用 nvidia-smi / nvcc 即可验证 GPU+CPU 双资源。
05OOD-Web 提交介绍(重点)
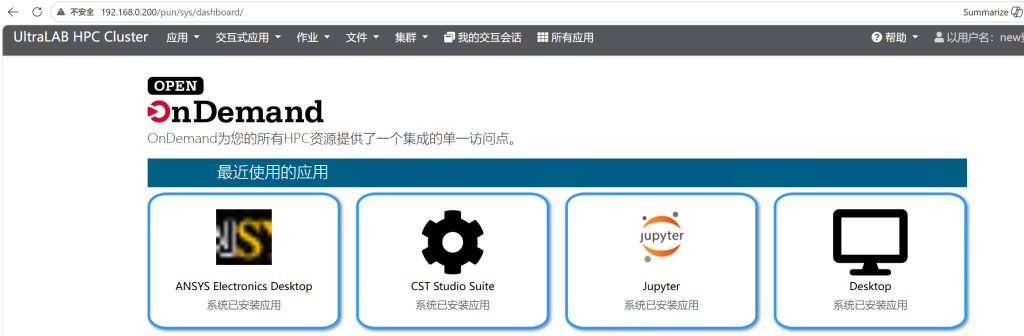
Open OnDemand Web submission — 把命令行 HPC 变成浏览器表单
这是面向非命令行用户(科研团队、教学、工程客户)最重要的价值点:Open OnDemand 把复杂的 Slurm 命令行封装成图形化 Web 表单,用户无需学习 sbatch 语法即可提交 GPU 作业、启动交互式软件。
5.1 三类 Web 提交入口
🖥️
Batch Connect 交互式
一键启动 Jupyter、MATLAB、ANSYS、ParaView、PyMOL 等 33 应用;表单选择节点/核数/GPU/时长,浏览器直达运行中的实例。
📜
批处理作业提交
粘贴脚本 + 填参数(分区/核数/GPU/时长/队列),后台 sbatch 执行,门户实时显示 RUNNING / COMPLETED 状态。
📊
作业与状态监控
activejobs / myjobs / projects 三应用查看队列、历史与项目配额;system-status 显示集群节点健康。
5.2 典型 GPU 作业 Web 提交流程
- 浏览器打开门户
http://192.168.0.200/pun/sys/dashboard/,用账户登录(已中文化界面); - 进入”作业”或目标应用(如 Jupyter / 自定义批处理),在表单中选择 分区=batch、CPU 核数、GPU 数量、运行时长;
- 粘贴/编辑作业脚本(或选择镜像),点击”提交”;
- 门户调用 Slurm 完成 TRES 混合分配(见 §04 实测),作业进入队列并调度到 GPU 节点;
- 在”activejobs”实时查看状态;交互式应用提交后浏览器自动打开运行中的实例;
- Grafana 仪表盘同步显示该 GPU 的利用率 / 显存 / 温度,实现”提交—运行—观测”闭环。
5.3 门户能力核查(实测)
| 能力 | 说明 | 状态 |
|---|---|---|
| 应用矩阵 | 33 个 sys 应用(EDA / CAE / AI / 数据科学 / 桌面 / 教学) | ✓ 全量 200 |
| 中文界面 | 导航分类、子分类、界面文案全量中文化(OOD_LOCALE=zh-CN + 补充 locale) | ✓ 生效 |
| Batch Connect | 交互式应用表单 → Slurm 调度 → 浏览器直达实例 | ✓ 链路通 |
| 作业管理 | activejobs / myjobs / projects 状态与历史 | ✓ 可用 |
| 安全模型 | Apache 前端 + 按用户 ondemand-nginx PUN + Passenger 隔离 | ✓ 运行 |
价值定位 OOD-Web 把”会命令行才会用 HPC”的门槛降为”会点鼠标就能用 HPC”。对客户而言,这意味着科研/教学/工程团队无需培训即可上云用 GPU,是降低 TCO、扩大用户面的关键差异化能力。
06全栈监控体系
Observability stack — Prometheus + DCGM + Grafana,全目标在线
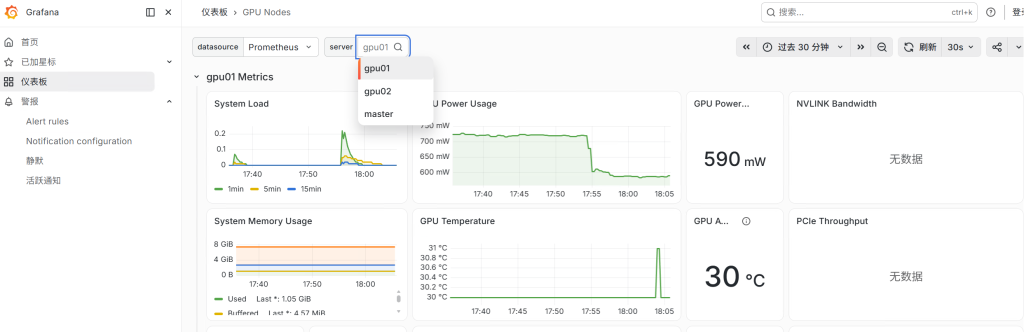
6.1 指标采集拓扑(实测 8 目标全部 up)
| 实例 | 端口 | Exporter | 采集内容 | 健康 |
|---|---|---|---|---|
| master | 9100 | node-exporter | CPU / 内存 / 磁盘 / 网络 | up |
| gpu01 | 9100 | node-exporter | CPU / 内存 / 磁盘 / 网络 | up |
| gpu02 | 9100 | node-exporter | CPU / 内存 / 磁盘 / 网络 | up |
| master | 9400 | DCGM-exporter | GPU 利用率 / 显存 / 温度 / 功耗 | up |
| gpu01 | 9400 | DCGM-exporter | GPU 利用率 / 显存 / 温度 / 功耗 | up |
| gpu02 | 9400 | DCGM-exporter | GPU 利用率 / 显存 / 温度 / 功耗 | up |
| master | 8080 | Slurm-exporter | 节点状态 / 作业数 / 队列 | up |
| localhost | 9090 | Prometheus | 自监控(up / 抓取延迟) | up |
6.2 Grafana 可视化
8/8
抓取目标在线
node / DCGM / Slurm 三类 exporter 全 up,无 down
2
核心仪表盘
GPU Nodes(GPU 利用率/显存/温度/功耗)+ SLURM Dashboard(节点/作业)
49
Grafana 插件
gauge / barchart / geomap / flamegraph / loki / pyroscope 等可视化与分析插件
1
数据源
Prometheus(localhost:9090),单一事实来源
节点无关设计 GPU 仪表盘以 $hostname 变量聚合,从 up{job="cluster",instance=~".*:9400"} 自动发现节点,避免硬编码——新增/更换节点无需改模板即可纳入监控。
已知限制(如实披露) GTX 1050(master / gpu02)无功耗传感器,DCGM_FI_DEV_POWER_USAGE 无数据,故功耗面板在该两节点显示 No data;GTX 750(gpu01)可正常读功耗。属硬件传感器差异,非故障。
07使用说明书
User guide — 三类用户的上手路径
7.1 角色与入口
| 角色 | 入口 | 典型操作 |
|---|---|---|
| Web 用户(科研/教学/工程) | 浏览器 http://192.168.0.200/pun/sys/dashboard/ | 表单提交作业 / 启动交互式应用 / 查看状态 |
| 命令行用户(开发者) | SSH 到 master | sbatch / srun / squeue / module load nvhpc |
| 运维/管理员 | Grafana :3000 + Prometheus :9090 | 看仪表盘 / 查指标 / 管配置 / 重跑 Ansible 剧本 |
7.2 命令行快速上手
Quick start · 命令行
# 1) 加载软件模块
module load nvhpc/23.7

# 2) 查看集群 / 节点 / 分区
sinfo -o "%P | %n | %c cores | %G gres | %s"
squeue -u $USER

# 3) 提交一个 GPU+CPU 混合作业
sbatch --partition=batch --cpus-per-task=4 --gpus=1 --time=00:02:00 job.sh

# 4) 交互验证 GPU(作业内)
srun --gpus=1 --time=00:02:00 nvidia-smi

# 5) 用 Enroot 容器跑带 GPU 的镜像
enroot create app.sif;  srun --gpus=1 enroot start app.sif bash
7.3 Web 门户快速上手
- 浏览器访问门户,输入账户登录(界面为中文);
- 在”应用”里点选要启动的软件(Jupyter / MATLAB / ANSYS / ParaView …);
- 在表单里选择分区、CPU 核数、GPU 数量、时长,点击”提交”;
- 交互式应用提交后浏览器自动打开运行实例;批处理作业在”activejobs”查看进度;
- 打开 Grafana 仪表盘,实时观察所分配 GPU 的利用率与显存。
GPU 可见性提示 GPU 仅在 Slurm 作业内可见(srun --gpus=1 nvidia-smi),普通 SSH 会话中 nvidia-smi 报”No devices”是预期行为(安全隔离),并非故障。
08专业模式销售优势报告
Professional-mode value & sales advantage — 面向采购/决策者的价值论证
以下从决策者视角,把技术能力翻译为可量化的商业价值,并给出加权评分。评分基于本报告已实测验证的能力项(非纸面参数)。
异构 GPU 调度
9.5
Web 零门槛提交
9.2
全栈可观测
9.0
声明式可交付
8.8
软件生态完整
8.5
安全隔离
8.2
① 异构算力,一份预算
CPU + GPU 混合 TRES 原子分配(实测 cpu=4+gpu=1),客户用一套集群同时跑 HPC 与 AI 负载,避免”两套系统”的重复投入。
② 零培训成本
OOD-Web 表单化提交 + 全中文界面,科研/教学/工程团队无需命令行培训即可用 GPU,直接扩大可服务用户面。
③ 看得见才信得过
Prometheus+DCGM+Grafana 全目标在线,GPU 利用率/显存/温度实时可见——把”黑盒算力”变成”透明资产”,便于计费与扩容决策。
④ 分钟级可交付/可复现
Ansible 声明式 + 幂等剧本,新节点纳管、故障重跑均为重放同一命令,交付与恢复的边际成本极低。
⑤ 软件即服务
33 应用 + 6 软件模块(NVIDIA HPC SDK / HPC-X),EDA/CAE/AI/数据科学开箱即用,减少客户自建软件栈的时间与许可碎片化。
⑥ 企业级安全
GPU 作业级隔离、按用户 PUN 隔离、门户认证,满足科研数据合规与多租户需求。
Sales Verdict · 销售结论
UltraLAB HPC Cluster 是”可实测、可验证、零门槛、可观测”的异构 GPU 算力服务。
核心卖点不是”参数多”,而是——每一项能力都已在本报告附实测证据:GPU+CPU 混合分配(§04)、Web 零门槛提交(§05)、全栈监控 8/8 在线(§06)。对决策者而言,这意味着低 TCO、低培训成本、高透明度、可快速扩容,且交付与故障恢复均为声明式可重放——风险可控、价值可量化。
诚实边界(增强可信度) 当前为 3 节点入门规模(GPU 为 GTX 级),面向”验证—教学—中小规模科研/工程”场景;面向大模型训练的更大显存/更高算力,可按同一套声明式架构横向扩展到 A 系列/H 系列 GPU,方法论与交付物不变。
09结论与交付物
Conclusion & deliverables
- 集群交付完成:3 节点(1 控制 + 2 GPU 计算)全部在线,Slurm 调度、OOD 门户、监控栈均正常运行。
- 软件栈核查通过:6 个 Lmod 模块、33 个门户应用、49 个监控插件、2 个仪表盘全部在册且状态正常。
- 异构能力实测:Slurm GPU+CPU 混合 TRES 分配、CPU 亲和性、GPU 可见性、CUDA 内核执行全链路验证成功(§04 证据)。
- Web 提交可用:OOD-Web 表单化提交 + 全中文界面,面向非命令行用户零门槛(§05)。
- 可观测闭环:Prometheus 8/8 目标 up,Grafana GPU/SLURM 仪表盘实时呈现(§06)。
- 声明式可复现:全部由 Ansible 剧本驱动,交付与恢复为幂等重放,边际成本低。
交付物清单
| 交付物 | 形态 | 位置 / 入口 |
|---|---|---|
| GPU 集群 | 3 节点在线 | master / gpu01 / gpu02(batch 分区) |
| Web 门户 | OOD 4.2 · 33 应用 · 中文 | http://192.168.0.200/pun/sys/dashboard/ |
| 监控看板 | Grafana 13.1.0 · 2 仪表盘 | http://192.168.0.200:3000(admin/deepops) |
| 软件栈 | NVIDIA HPC SDK 23.7 · CUDA 12.8.2 | /sw(Lmod 模块) |
| 本报告 | HTML 技术白皮书 | http://192.168.0.200/ultralab-report.html |
A附录:实测证据日志
Appendix — raw verification log(2026-10-09)
raw log · 关键命令与输出摘要
$ sinfo -o "%P | %n | %c cores | %G gres | %m minmem | %s"
batch* | gpu01 | 8 cores | gpu:1(S:0) | 7249 minmem | ...
batch* | gpu02 | 6 cores | gpu:1(S:0) | 14882 minmem | ...

$ scontrol show nodes | grep CfgTRES
gpu01: CfgTRES=cpu=8,mem=7249M,billing=8,gres/gpu=1   State=IDLE
gpu02: CfgTRES=cpu=6,mem=14882M,billing=6,gres/gpu=1  State=IDLE

$ sbatch --cpus-per-task=4 --gpus=1 --time=00:02:00 hybrid_job.sh   # job 51
AllocTRES=cpu=4,mem=7249M,node=1,billing=4,gres/gpu=1   State=COMPLETED ExitCode=0:0

# 作业内(job 57)
nproc=4  taskset=33  CUDA_VISIBLE_DEVICES=0
GPU: NVIDIA GeForce GTX 750  CC=5.0  SMs=4  显存=969MB
cudaMalloc: no error   kernel launch+sync: no error

$ curl :9090/api/v1/targets   # 8/8 up
gpu01:9100 gpu02:9100 master:9100 master:9400 gpu01:9400 gpu02:9400 master:8080 localhost:9090

$ curl :3000/api/health   # Grafana
version=13.1.0  database=ok
UltraLAB HPC Cluster
技术白皮书与销售优势报告 · 基于真实运行环境逐项实测 · 报告日期 2026-10-09
Slurm 26.05.3 · Open OnDemand 4.2 · CUDA 12.8.2 · NVIDIA HPC SDK 23.7 · Prometheus 3.13.0 · Grafana 13.1.0 · Rocky Linux 9
联系人:郭张斌 电话(微信):13520538244











